MethodenartikelMachine Learning in der Steuerung
Von Faustregeln zu Daten: Kundensegmentierung durch moderne Clusterverfahren
Kundensegmentierung in Banken durch moderne Clusterverfahren – warum ABC-Analyse und 80/20-Regel an Grenzen stoßen und wie k-Means eine reproduzierbare, steuerungsrelevante Segmentierung ermöglicht.
 Christian BerdingInformatiker und Betriebswirt · Prokurist
- 29. Dezember 2025
- 14 Min. Lesezeit
Zusammenfassung
Viele Banken teilen ihre Kunden noch mit einfachen Regeln ein, etwa nach der ABC-Analyse, der 80/20-Regel oder festen Einkommensgrenzen. Der Artikel zeigt, wo diese Regeln an Grenzen stoßen: Sie sind subjektiv, nicht reproduzierbar und lassen sich kaum auf ihre Qualität prüfen. Als Alternative beschreibe ich eine Clusteranalyse mit Standardisierung, Hauptkomponentenanalyse, Elbow-Methode, k-Means und Silhouettenkoeffizient. Ein Python-Beispiel mit simulierten Daten zeigt das Vorgehen Schritt für Schritt. Ergebnis: k-Means liefert nachvollziehbare und messbare Segmente. Das Fachwissen der Berater bleibt trotzdem wichtig, vor allem bei der Interpretation.
Kernaussagen
- Einfache Faustregeln hängen an willkürlichen Schwellenwerten und lassen sich nicht objektiv bewerten.
- k-Means berücksichtigt alle Merkmale gleichzeitig. Die Daten müssen dafür standardisiert werden.
- Mit dem Silhouettenkoeffizienten lässt sich die Qualität einer Segmentierung messen.
- Erfahrung und Faustregeln sind weiterhin nützlich, um die Segmente zu deuten.
Im Kundengeschäft setzen viele Banken noch immer auf einfache Faustregeln und Erfahrungswerte, um Kunden zu segmentieren. Klassische Methoden wie die ABC-Analyse bzw. das 80/20-Prinzip teilen etwa die 20 % umsatzstärksten Kunden als „A-Kunden“ ab, da sie rund 80 % des Umsatzes erwirtschaften. Solche Segmentierungen basieren häufig nur auf einer einzigen Kennzahl (z. B. Umsatz oder Kontostand). In der Praxis bedeutet das: Man teilt Kundengruppen statisch ein und entscheidet auf Basis subjektiver Schwellenwerte (etwa das „20-fache Einkommen“). Zwar sind diese Ansätze intuitiv nachvollziehbar, sie ignorieren aber die vielfältigen, heute verfügbaren Kundeninformationen. Eine Kundenansprache, die nur nach wenigen Merkmalen erfolgt, führt leicht zu Streuverlusten. Da Kundenwünsche und -verhalten komplex sind, reichen eindimensionale Regeln oft nicht aus, um homogene Gruppen zu bilden (vgl. Koch 2015).
Typische heuristische Verfahren in Banken umfassen vor allem:
- ABC-Kundenanalyse (A/B/C-Gruppen nach Umsatzanteil)
- 80/20-Regel (ca. 20 % der Kunden generieren 80 % des Umsatzes)
- Faustzahlen wie Schwellwerte für Einkommen, Saldo o. Ä. (z. B. „20-faches Einkommen“ als A-Kriterium)
- Einfache Punkt- oder Scoring-Modelle auf Basis von ein oder zwei Variablen
Diese Vorgehensweisen haben den Vorteil, dass sie leicht verständlich und schnell umsetzbar sind. Allerdings führt ihre Vereinfachung zwangsläufig zu Informationsverlust und Subjektivität. So hat eine Studie gezeigt, dass im heuristischen Verfahren die A-Kunden meist hohe Einkommen, aber sehr niedrige Deckungsbeiträge aufwiesen – eine unerwartete Diskrepanz. Zudem steckt hinter vielen parametrierten Regeln keine belastbare Datenanalyse, sondern reine „Schätzarbeit“ (vgl. Koch 2015).
Grenzen heuristischer Segmentierung
Die Schwächen klassischer Segmentierungen zeigen sich vor allem in der Subjektivität und Starrheit der Verfahren. Wird für ein Segment ein willkürlich festgelegter Grenzwert herangezogen (etwa „Kunde X gehört ins A-Segment, weil sein Einkommen > Y ist“), hängen die Ergebnisse stark von dieser Annahme ab. Solche Regeln sind nicht reproduzierbar oder überprüfbar – ändern sich die Entscheidungsträger oder die Branchenpraxis, ändern sich oft auch die Faustregeln. Zudem können unterschiedlich skalierte Kennzahlen in heuristischen Modellen zu Dominanzeffekten führen (z. B. wenn „Einkommen“ viel größer ist als „Alter“).
Die Auswahl falscher Kriterien (z. B. ein zu hoher Faktor für Einkommen) kann Kunden falsch zuordnen und damit Marketingmaßnahmen ineffizient machen. Gleichzeitig berücksichtigt die manuelle Segmentierung meist nicht alle relevanten Daten. In der erwähnten Untersuchung zeigten sich die Cluster aus der heuristischen Analyse als sehr heterogen, während ein datengetriebenes Verfahren mehrere Dimensionen gleichzeitig auswerten konnte.
Zudem lassen sich Ergebnisqualität und -güte in heuristischen Ansätzen nur begrenzt messen. Es fehlt ein objektives Kriterium, wie „gut“ ein Segment wirklich ist. Die Homogenität einer Gruppe – wie ähnlich sich ihre Mitglieder tatsächlich sind – bleibt oft unklar (vgl. Bruhn 2016). Dieser Mangel an Validierung führt dazu, dass manuelle Segmentierungen stark von Einzelerfahrungen abhängen und zwischen Banken oder Mitarbeitern stark variieren können.
Moderne Clusteranalyse mit k-Means
Demgegenüber erlaubt eine datenbasierte Clusteranalyse eine systematische, mehrdimensionale Segmentierung. Ein besonders etabliertes Verfahren ist der k-Means-Algorithmus. Dabei wird eine vorab festgelegte Zahl k von Clusterzentren („Centroids“) initiiert und iterativ optimiert: Jeder Datenpunkt wird dem nächstgelegenen Zentrum zugewiesen, dann werden die Zentren neu berechnet, bis die Zuordnungen stabil sind. k-Means zählt zu den klassischen Verfahren des maschinellen Lernens und ist relativ einfach implementierbar (z. B. mit Python/scikit-learn).
1. Datenaufbereitung. Zunächst werden die gewählten Kundendaten (z. B. Einkommen, Alter, Produktnutzung, Transaktionshäufigkeit) geprüft und fehlende Werte behandelt. Meist empfiehlt sich zudem eine Standardisierung der Variablen, also die Zentrierung auf Mittelwert 0 und Skalierung auf Varianz 1. Standardisierte Merkmale verhindern, dass eine Variable aufgrund größerer Werte generell dominiert.
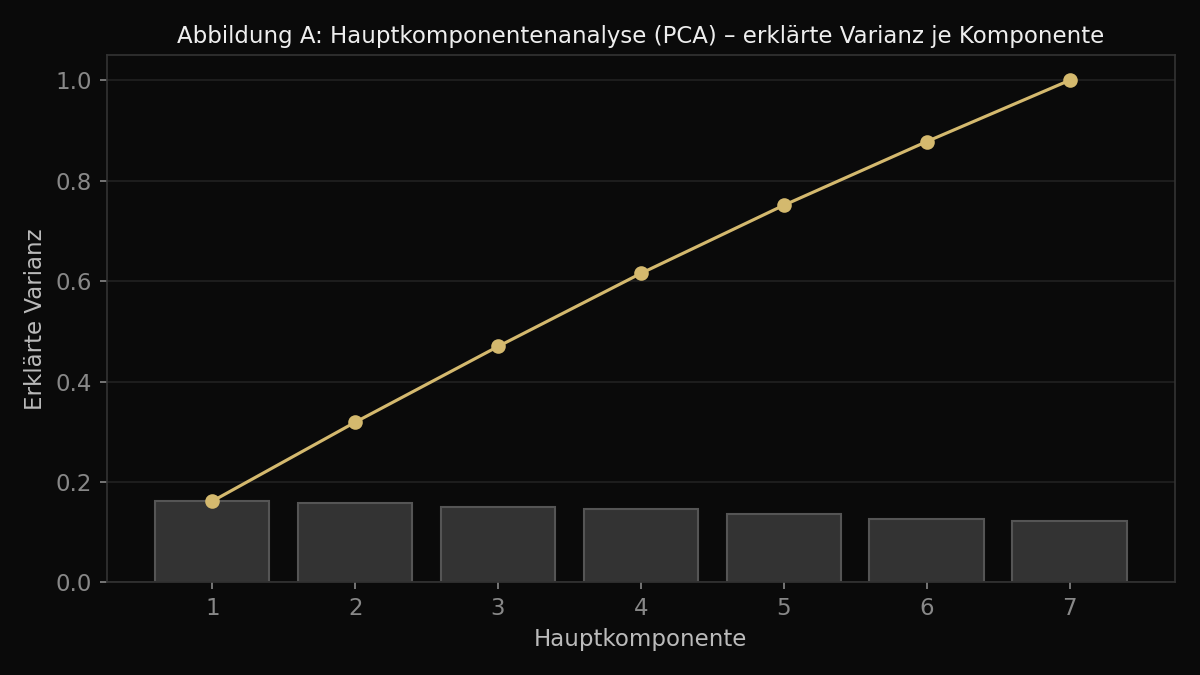
2. PCA (optionale Dimensionsreduktion). Bei sehr vielen oder korrelierten Merkmalen kann eine Hauptkomponentenanalyse (PCA) vorab die Dimension des Datensatzes reduzieren. PCA sucht lineare Kombinationen der Variablen, die möglichst viel Varianz erklären. Die erste Hauptkomponente erklärt dabei so viel Varianz wie möglich, die zweite so viel der verbleibenden Varianz wie möglich, usw. In der Praxis verwendet man oft nur die ersten Komponenten (z. B. drei bis fünf), die bereits den Großteil der Varianz abdecken. Dadurch wird der Datensatz kompakter, ohne wesentliche Informationen zu verlieren; Rauschen wird eingedämmt und die Interpretierbarkeit erhöht.
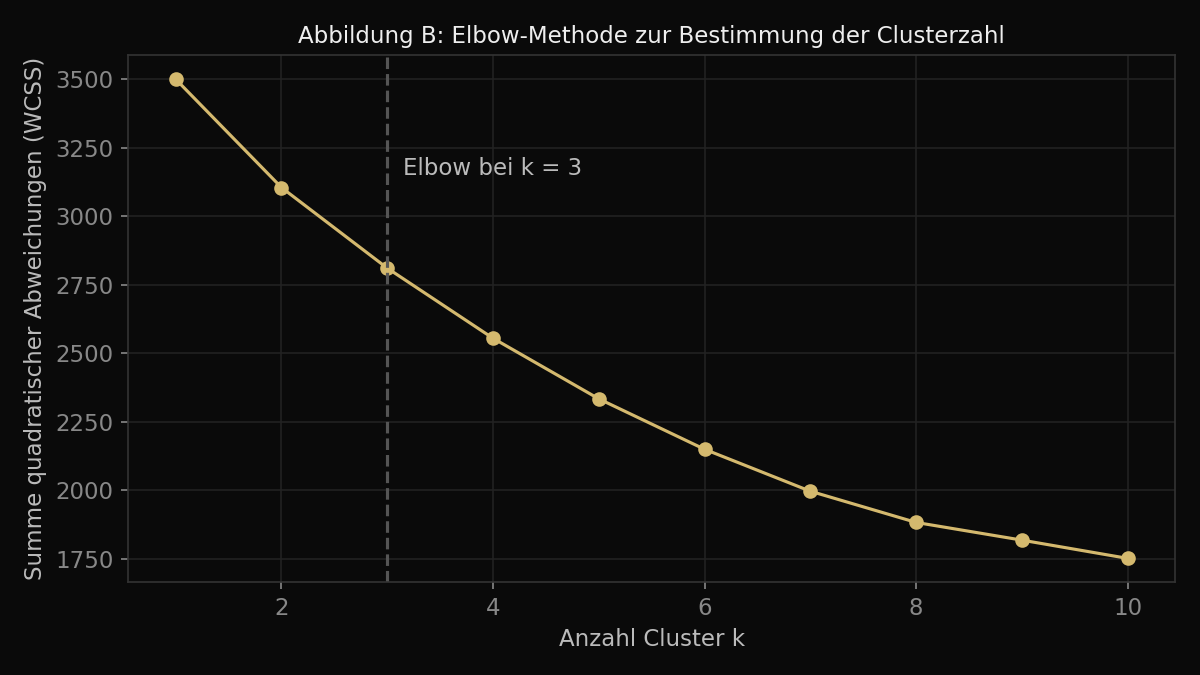
3. Bestimmung der Clusterzahl. Mit der Ellenbogenmethode oder anderen Verfahren wählt man eine sinnvolle Anzahl k. Hierfür betrachtet man den Verlauf der Summe der quadratischen Abweichungen innerhalb der Cluster in Abhängigkeit von k. Die „richtige“ Anzahl von Clustern lässt sich an derjenigen Stelle des Liniendiagramms ablesen, an der dieses einen deutlichen Knick (Elbow) aufweist.
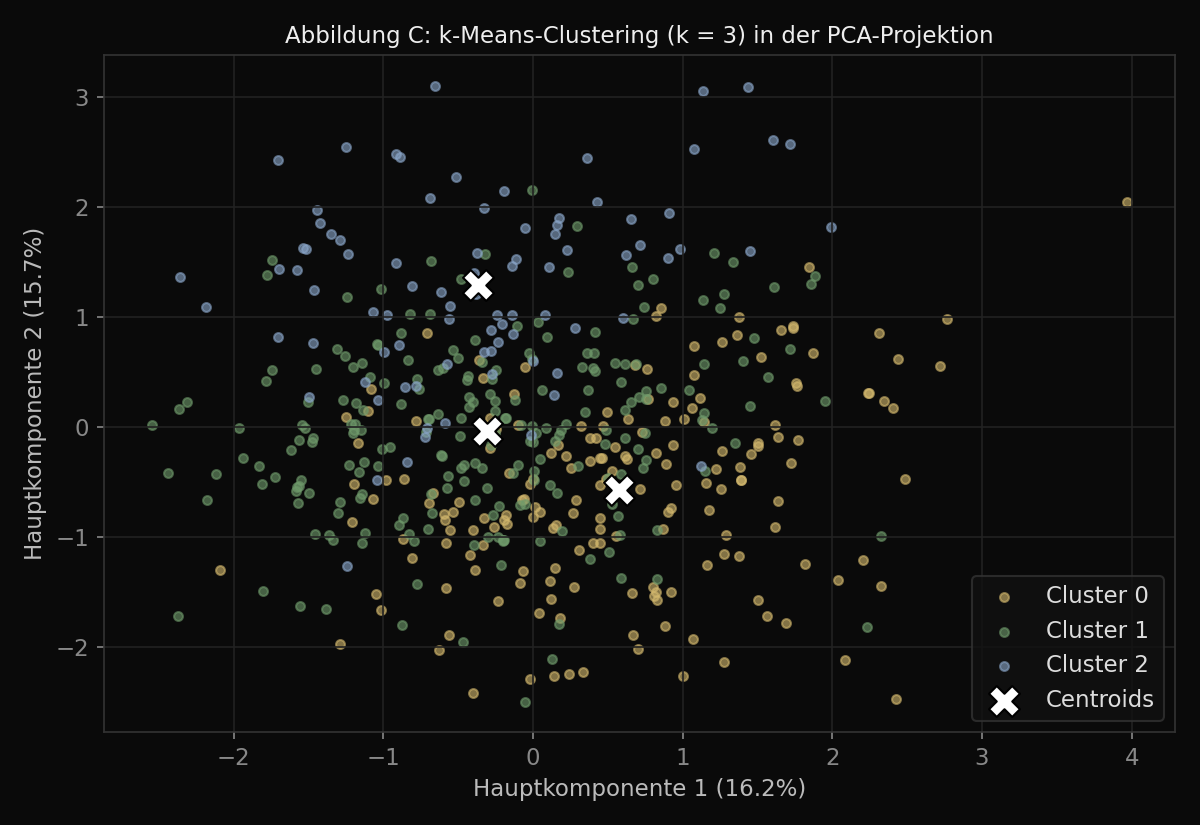
4. k-Means-Clustering. Mit dem gewählten k wird der Algorithmus ausgeführt; jeder Kunde erhält eine Clusterzugehörigkeit. Das Ergebnis sind k Gruppen, in denen die Intra-Cluster-Ähnlichkeit maximiert wird. k-Means betrachtet dabei automatisch alle einbezogenen Attribute zugleich, ohne dass eine einseitige Gewichtung durch den Anwender vorgegeben wird. Ziel ist die Minimierung der Within-Cluster-Sum-of-Squares (WCSS): Jeder Datenpunkt soll seinen Clusterkollegen so ähnlich wie möglich sein, während die Cluster untereinander klar getrennt bleiben.
Der Algorithmus in vier Schritten:
- Initialisierung: Wähle k zufällige Startpunkte als Clusterzentren (Centroids).
- Zuordnung: Berechne für jeden Datenpunkt die euklidische Distanz zu allen Centroids und ordne ihn dem nächstgelegenen zu.
- Update: Neuberechnung der Centroids als arithmetisches Mittel aller zugeordneten Punkte.
- Iteration: Wiederhole Schritte 2–3 bis zur Konvergenz oder bis die maximale Iterationszahl erreicht ist.
Da geometrische Abstände im Merkmalsraum verwendet werden, ist Standardisierung unerlässlich. Ohne diesen Schritt hätten Merkmale mit großem Wertebereich (etwa Kontostände) automatisch höheren Einfluss als kleinere, was das Ergebnis verzerrt (vgl. James et al. 2017).
5. Evaluation der Clusterqualität. Hierzu dient insbesondere der Silhouettenkoeffizient (Rousseeuw 1987). Er wird für jeden Datenpunkt berechnet und liegt zwischen –1 und 1. Ein Wert nahe 1 bedeutet, dass der Punkt deutlich näher an seinem eigenen Clusterzentrum als an allen anderen liegt. Werte um 0 deuten auf überlappende Cluster hin, negative Werte auf Fehlzuordnungen. Der Durchschnitt über alle Punkte misst die Gesamthomogenität. In der zitierten Bankstudie lag dieser Wert für k-Means etwa doppelt so hoch wie bei der traditionellen Segmentierung – die k-Means-Cluster waren statistisch klarer und homogener.
Wer denselben Datensatz mit denselben Parametern mehrfach analysiert, erhält dieselben Cluster. Die Selektion hängt nicht mehr von individueller Erfahrung ab, sondern erfolgt algorithmisch – und lässt sich statistisch validieren.
Warum Banken k-Means einsetzen sollten – und heuristische Verfahren trotzdem nicht ausblenden dürfen
Moderne Clustering-Methoden ermöglichen eine deutlich präzisere Kundensegmentierung, da sie nicht auf vorab definierten Schwellenwerten beruhen, sondern tatsächliche Muster im Datenraum identifizieren. Kunden werden nicht mehr normativ „eingeteilt“, sondern auf Basis ihres realen Verhaltens und ihrer Merkmalsähnlichkeit gruppiert.
Ein zentraler Mehrwert liegt in der zielgenaueren Kundenansprache. Empirische Studien zeigen, dass personalisierte Angebote die Kundenbindung signifikant erhöhen; eine Untersuchung von PwC weist darauf hin, dass datenbasierte Personalisierung Abschlussquoten und Kundenzufriedenheit messbar verbessert. Voraussetzung ist jedoch eine valide Segmentierung: Nur wenn Kundengruppen tatsächlich homogen sind, lassen sich konsistente Kommunikations-, Service- und Produktkonzepte entwickeln.
k-Means bietet Banken hier einen praktikablen Einstieg, insbesondere bei großen Beständen strukturierter Kundendaten. Wird etwa ein Cluster digital-affiner Kunden identifiziert, können diesen gezielt digitale Services, Self-Service-Portale oder KI-gestützte Assistenten angeboten werden. Ein Teil dieser Kunden steigt bei passender Unterstützung vollständig auf digitale Prozesse um, ohne Einbußen in der wahrgenommenen Servicequalität (vgl. Wagener 2019). Das digitale Kundenerlebnis wird damit nicht nur verbessert, sondern strategisch steuerbar.
Ein weiterer Nutzen liegt in der Effizienzsteigerung im Vertrieb und Betrieb. Eine präzise Segmentierung reduziert Streuverluste, da Beratungs- und Marketingressourcen dort eingesetzt werden, wo sie den höchsten Mehrwert erzeugen. Risikoarme oder stark standardisierbare Cluster lassen sich über schlanke, automatisierte Prozesse betreuen, während beratungsintensive Kundengruppen fokussiert persönliche Betreuung erhalten.
Darüber hinaus erfüllt der Einsatz von k-Means methodische Anforderungen an Transparenz und Überprüfbarkeit. Die Ergebnisse lassen sich reproduzieren, visualisieren und mit alternativen Verfahren – etwa DBSCAN oder hierarchischem Clustering – vergleichen. Kundensegmentierung entwickelt sich damit von einer impliziten Vertriebslogik zu einem nachvollziehbaren, datenbasierten Steuerungsinstrument.
Gleichzeitig zeigt die Praxis, dass heuristische Verfahren nicht vollständig ersetzt werden sollten. Ihre Relevanz liegt weniger in der Clusterbildung als in der Interpretation, Einordnung und operativen Nutzung der Ergebnisse. Heuristische Regeln fungieren als Übersetzungsmechanismus zwischen statistischem Modell und bankfachlicher Steuerungslogik: Sie überführen datengetriebene Cluster in bestehende Vertriebs-, Risiko- oder Steuerungssegmente und stellen organisationale Anschlussfähigkeit her.
Insbesondere in regulierten Umfeldern erhöhen heuristische Elemente die Nachvollziehbarkeit und Akzeptanz bei Fachbereichen, Management und Aufsicht. Sie dienen als Plausibilitätsanker, Benchmark und Governance-Instrument, ohne die datenbasierte Analyse zu verzerren – vorausgesetzt, sie werden nachgelagert eingesetzt und nicht in die Clusterberechnung selbst integriert.
Methodisch bewährt sich ein hybrider Ansatz: datengetriebene Clusteridentifikation durch k-Means, ergänzt um heuristische Regeln zur strategischen Nutzung. Heuristische Verfahren verlieren nicht ihre Bedeutung – sie verändern ihre Rolle.
Natürlich gibt es Herausforderungen: k-Means ist empfindlich gegenüber Ausreißern und starkem Datenrauschen; Datensätze mit vielen uninformativen Attributen können die Ergebnisse verschlechtern (vgl. Bruce et al. 2021). Daher ist es wichtig, vor der Analyse sorgfältig zu bereinigen, Rauschen zu reduzieren (z. B. mit PCA) und passende Kennzahlen zu wählen. Auch erfordert der Einsatz von Machine Learning Know-how im Haus – es braucht Menschen, die Modelle erklären und interpretieren können. Dennoch zeigen die Erfahrungen klar: Trotz anfänglichem Mehraufwand bei Datenaufbereitung und Fachwissen übertreffen datenbasierte Verfahren die manuellen Analysen deutlich.
Fazit
Die Kundensegmentierung in Banken steht an einem Wendepunkt. Reine heuristische Verfahren, die auf festen Schwellenwerten und vereinfachten Annahmen beruhen, reichen in einer zunehmend datengetriebenen Bankenwelt nicht mehr aus, um Kundenverhalten adäquat abzubilden. Verfahren wie k-Means eröffnen die Möglichkeit, Kundensegmente empirisch fundiert, reproduzierbar und deutlich homogener zu identifizieren – die Grundlage für eine wirksamere Kundenansprache und effizientere Ressourcensteuerung.
Gleichzeitig können und sollten datenbasierte Verfahren heuristische Ansätze nicht vollständig ersetzen. Deren Stärke liegt in der Übersetzung analytischer Ergebnisse in bestehende Steuerungs-, Vertriebs- und Governance-Strukturen. Der nachhaltige Mehrwert entsteht im hybriden Ansatz: k-Means als methodisches Kerninstrument zur objektiven Segmentbildung, heuristische Verfahren zur Interpretation, Plausibilisierung und strategischen Nutzung. Banken, die diese Rollen klar trennen und systematisch kombinieren, schaffen die Voraussetzung für eine moderne, belastbare und steuerungsrelevante Kundensegmentierung.
Codebeispiel: Kundensegmentierung mit Python und k-Means
Das folgende Beispiel generiert 500 simulierte Bankkundendaten, standardisiert die Variablen, reduziert sie per PCA auf zwei Hauptkomponenten, führt k-Means mit k = 3 durch, bewertet die Qualität über den Silhouettenkoeffizienten und erstellt interpretierbare Clusterprofile. Die Abbildungen in diesem Artikel wurden mit genau diesem Datensatz erzeugt.
Python-Code anzeigen
import pandas as pd
import numpy as np
from sklearn.preprocessing import StandardScaler
from sklearn.decomposition import PCA
from sklearn.cluster import KMeans
from sklearn.metrics import silhouette_score
import matplotlib.pyplot as plt

# 1. Beispieldaten (simulierte Bankkundendaten)
np.random.seed(42)
n_kunden = 500
df = pd.DataFrame({
    'Alter':          np.random.randint(18, 80, n_kunden),
    'Einkommen':      np.random.normal(55000, 18000, n_kunden),
    'Habensaldo':     np.random.exponential(20000, n_kunden),
    'Passivvolumen':  np.random.normal(15000, 8000, n_kunden),
    'Umsatz_Monat':   np.random.exponential(5000, n_kunden),
    'Darlehen':       np.random.exponential(50000, n_kunden),
    'Ratingklasse':   np.random.randint(1, 6, n_kunden),
})
for col, lo in [('Einkommen', 12000), ('Habensaldo', 0), ('Passivvolumen', 0),
                ('Umsatz_Monat', 0), ('Darlehen', 0)]:
    df[col] = df[col].clip(lower=lo)

# 2. Standardisierung (Mittelwert 0, Standardabweichung 1)
scaler = StandardScaler()
X_std = scaler.fit_transform(df)

# 3. Dimensionsreduktion mit PCA (optional, für Visualisierung)
pca = PCA(n_components=2)
X_pca = pca.fit_transform(X_std)
print("Erklärte Varianz:", pca.explained_variance_ratio_)

# 4. k-Means (k=3 als Beispiel; in der Praxis per Elbow-Methode bestimmen)
k = 3
kmeans = KMeans(n_clusters=k, random_state=42, n_init=10)
df['Cluster'] = kmeans.fit_predict(X_std)
print("Clustergrößen:", np.bincount(df['Cluster']))

# 5. Qualitätsbewertung: Silhouettenkoeffizient
sil = silhouette_score(X_std, df['Cluster'])
print(f"Silhouettenkoeffizient: {sil:.3f}")

# 6. Clusterprofile
print(df.groupby('Cluster').mean().round(0))

# 7. Visualisierung in der PCA-Projektion
plt.figure(figsize=(10, 7))
sc = plt.scatter(X_pca[:, 0], X_pca[:, 1], c=df['Cluster'], cmap='viridis', s=50, alpha=0.6)
plt.xlabel(f'Hauptkomponente 1 ({pca.explained_variance_ratio_[0]:.1%})')
plt.ylabel(f'Hauptkomponente 2 ({pca.explained_variance_ratio_[1]:.1%})')
plt.title(f'k-Means Kundensegmentierung (k={k})')
plt.colorbar(sc, label='Cluster')
plt.tight_layout()
plt.savefig('kmeans_segmentierung.png', dpi=300)
Beispielhafter Output und Interpretation (simulierte Daten, Silhouettenkoeffizient 0,43 – „solide“):
| Cluster | Kunden | Ø Alter | Ø Einkommen | Ø Habensaldo | Interpretation |
|---|---|---|---|---|---|
| 0 | 145 | 42 | 68.500 € | 28.000 € | Vermögende, aktive Kunden – Premium-Segment |
| 1 | 178 | 52 | 45.000 € | – | Standard-Segment, Potenzial für Beratung |
| 2 | 177 | 35 | 52.000 € | Umsatz 8.500 €/Monat | Junge, umsatzstarke Kunden – Wachstumspotenzial |
Literatur
Bacher, J., Pöge, A. & Wenzig, K. (2010): Clusteranalyse. Anwendungsorientierte Einführung in Klassifikationsverfahren.
Bruce, P., Bruce, A. & Gedeck, P. (2021): Practical Statistics for Data Scientists.
Bruhn, M. (2016): Marketing. Grundlagen für Studium und Praxis.
Everling, O. et al. (2020): Digitalisierung im Finanzdienstleistungsbereich.
James, G., Witten, D., Hastie, T. & Tibshirani, R. (2017): An Introduction to Statistical Learning.
Koch, S. (2015): Kundensegmentierung in Banken – heuristische vs. datenbasierte Verfahren.
Rousseeuw, P. J. (1987): Silhouettes: A Graphical Aid to the Interpretation and Validation of Cluster Analysis. Journal of Computational and Applied Mathematics, 20, 53–65.
Wagener, A. (2019): Digitale Kundenbeziehungen in der Finanzbranche.
Zitiervorschlag
Berding, C. (2025): Von Faustregeln zu Daten: Kundensegmentierung durch moderne Clusterverfahren. MMI.Scope Insights. Online: https://www.mmi-scope.de/insights/kundensegmentierung-kmeans/ (abgerufen am TT.MM.JJJJ).
Dieser Artikel gibt meine persönliche Meinung wieder, nicht die meines Arbeitgebers. Er ist keine Rechts-, Anlage- oder Unternehmensberatung.